En resumen
- Una IA conforme al RGPD necesita cuatro cosas: un contrato de encargo del tratamiento según el artículo 28, tratamiento en la UE o en Alemania, el entrenamiento desactivado y una base jurídica para cualquier transferencia a EE. UU.
- El Marco de Privacidad de Datos UE-EE. UU. sigue en vigor en octubre de 2026, pero hay un recurso pendiente y la sentencia del Tribunal Supremo de EE. UU. sobre la FTC lo ha debilitado, así que mantenga las cláusulas contractuales tipo como alternativa.
- Azure, AWS, Google y OpenAI ofrecen tratamiento en la UE; la API propia de Anthropic no, así que utilice Claude a través de Amazon Bedrock o de Google Vertex AI en la UE.
- La DSK alemana prefiere los sistemas técnicamente cerrados y espera una evaluación de impacto para muchos usos de la IA, incluidos los chatbots de cara al cliente.
- La conservación es el riesgo más olvidado: los registros de seguridad del proveedor, las respuestas almacenadas y sus propias trazas contienen datos personales.
Información general, no asesoramiento jurídico ni fiscal. Las leyes y los plazos cambian: compruebe las fuentes y consulte a su abogado o asesor fiscal antes de actuar.
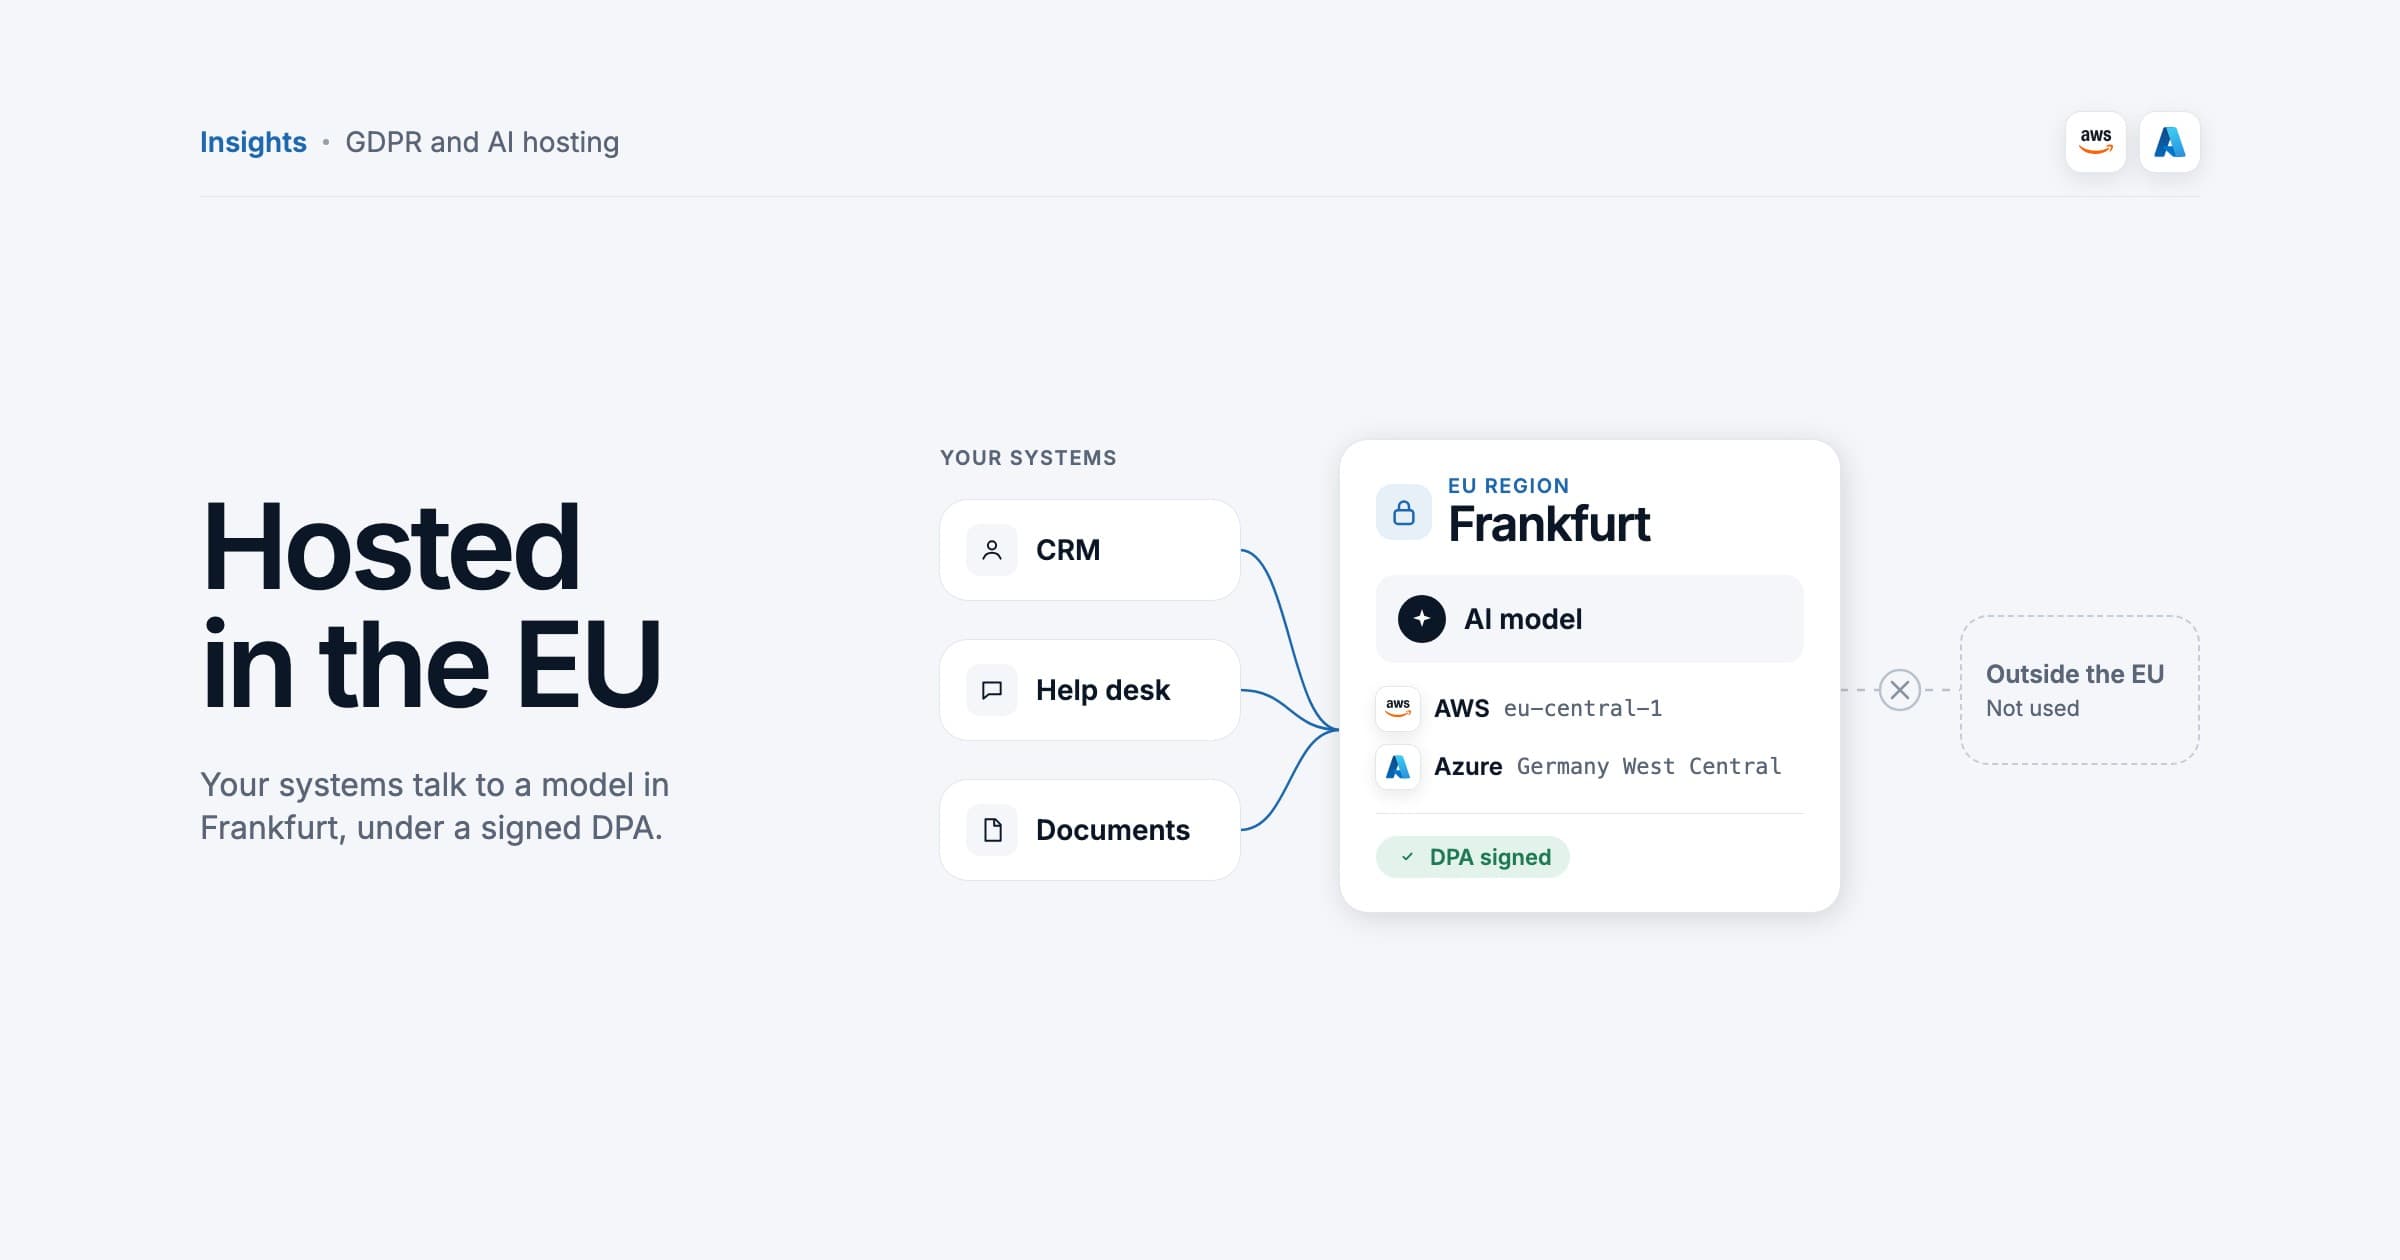
Una IA conforme al RGPD depende menos del modelo que de la ruta que siguen sus datos. Cuando un empleado pega el correo de un cliente en un chatbot, o un agente llama a un modelo a través de una API, los datos personales van a un proveedor que actúa como su encargado del tratamiento, a menudo se almacenan para la vigilancia de abusos hasta 30 días y pueden tratarse fuera de la UE salvo que usted elija otra cosa. Para cumplir necesita cuatro cosas: un contrato de encargo del tratamiento según el artículo 28 del RGPD, un despliegue que trate los datos en la UE o en Alemania, el entrenamiento con sus datos desactivado y una base jurídica para cualquier transferencia a EE. UU.
Esta guía refleja la situación a 11 de octubre de 2026. Las opciones de los proveedores cambian cada pocos meses, así que confirme cada ajuste en su propio contrato y en su consola.
Adónde van sus datos cuando alguien utiliza un modelo de IA
Un prompt rara vez hace un solo viaje. Dibuje estos saltos antes de debatir qué modelo es el mejor, porque cada uno es un destinatario, un lugar de almacenamiento o ambas cosas.
- La interfaz. Un chat en el navegador, un complemento de Office, un plugin del CRM. Las versiones de consumo y las empresariales tienen condiciones distintas, incluso del mismo proveedor.
- Su capa de orquestación. El servidor o la herramienta low-code que construye el prompt y guarda el estado. Si es un SaaS alojado en EE. UU., los datos han salido de la UE antes de que ningún modelo los vea.
- El endpoint del modelo. Dónde se ejecuta físicamente la inferencia. Los despliegues «globales» pueden enviar una solicitud a cualquier región con capacidad libre.
- El almacenamiento de seguridad del proveedor. La mayoría de los proveedores guardan prompts y resultados para vigilar abusos, normalmente hasta 30 días, salvo que se le apruebe la retención cero de datos.
- Las funciones con estado. Hilos, respuestas almacenadas, archivos, almacenes vectoriales y cachés persisten hasta que los borre.
- Las herramientas que llama el agente. Búsqueda web, grounding, correo, tickets. Cada llamada a una herramienta puede enviar datos personales a otro destinatario.
- Sus propios registros. Los registros de prompts, las herramientas de trazas y los conjuntos de datos de evaluación suelen contener la copia más completa de todas.
Responsable, encargado y el contrato de encargo del tratamiento
Cuando su empresa decide por qué y cómo entran datos personales en un servicio de IA, usted es el responsable del tratamiento. Un proveedor que ejecuta el modelo solo siguiendo sus instrucciones, como Microsoft con Azure OpenAI o AWS con Bedrock, es normalmente su encargado del tratamiento. La DSK, el órgano conjunto de las autoridades alemanas de protección de datos, comparte este criterio: utilizar una aplicación de IA externa en la nube para fines propios suele crear una relación de encargo según el artículo 28, que exige un contrato. Si ejecuta un modelo de pesos abiertos en sus propios servidores para sus propios fines, normalmente es el único responsable y no hay ningún proveedor de modelos con el que contratar.
Cuando se vaya a realizar un tratamiento por cuenta de un responsable del tratamiento, este elegirá únicamente un encargado que ofrezca garantías suficientes para aplicar medidas técnicas y organizativas apropiadas, de manera que el tratamiento sea conforme con los requisitos del presente Reglamento y garantice la protección de los derechos del interesado.
En la práctica, el contrato de encargo es el anexo estándar del proveedor a sus condiciones empresariales o de API. Los accesos de consumo no suelen incluirlo, y la DSK da por hecho que el uso descontrolado de estas herramientas por parte del personal ya es una realidad en muchas organizaciones: cierre primero esa brecha.
- Tratamiento solo según sus instrucciones documentadas, incluido no utilizar sus datos para entrenar los modelos del proveedor (artículo 28, apartado 3, letra a).
- Una lista actualizada de subencargados con sus ubicaciones, y el derecho a oponerse a otros nuevos (artículo 28, apartados 2 y 4).
- Dónde se tratan y dónde se almacenan los datos, indicado por separado, incluido el acceso de soporte desde fuera de la UE.
- Plazos de conservación de prompts, resultados, archivos y registros, y supresión al final del contrato (artículo 28, apartado 3, letra g).
- El mecanismo de transferencia para todo lo que se trate fuera del EEE: adecuación, cláusulas contractuales tipo o ambas.
- Pruebas de seguridad, por ejemplo una certificación ISO/IEC 27001 o un informe BSI C5.
Transferencias internacionales: el Marco de Privacidad, las cláusulas tipo y la CLOUD Act
El capítulo V del RGPD (artículos 44 a 49) solo permite transferencias fuera del EEE sobre la base de una decisión de adecuación, de garantías adecuadas como las cláusulas contractuales tipo o de una excepción limitada. Para EE. UU., la decisión de adecuación es el Marco de Privacidad de Datos UE-EE. UU. de 10 de julio de 2023. Solo cubre a las empresas estadounidenses que se han autocertificado, así que compruebe cada proveedor en la lista oficial del DPF.
Situación a 11 de octubre de 2026: el marco está en vigor. El Tribunal General desestimó el recurso de anulación de Philippe Latombe el 3 de septiembre de 2025 (asunto T-553/23); su recurso de casación (asunto C-703/25 P) está pendiente ante el Tribunal de Justicia. El 29 de junio de 2026, el Tribunal Supremo de EE. UU. declaró en Trump v. Slaughter que el Presidente puede destituir libremente a los comisionados de la FTC. La independencia de la FTC es uno de los pilares de la decisión de adecuación, por lo que noyb pidió a la Comisión que la retirara y anunció una nueva impugnación judicial. Mientras un tribunal o la Comisión no actúen, las transferencias a empresas certificadas siguen siendo lícitas.
Las cláusulas contractuales tipo (Decisión de Ejecución (UE) 2021/914 de la Comisión) exigen una evaluación de impacto de la transferencia: ¿socava el derecho estadounidense, en particular la vigilancia de la sección 702 de la FISA, las cláusulas, y qué medidas complementarias cierran la brecha? Un modelo tiene que leer texto en claro para responder, así que el cifrado solo ayuda en tránsito y en reposo; minimizar lo que envía es lo que hace la mayor parte del trabajo.
La residencia de datos en la UE no zanja la cuestión. La CLOUD Act estadounidense permite a las autoridades de EE. UU. exigir a los proveedores estadounidenses que revelen los datos que estén en su posesión, custodia o control, dondequiera que se almacenen. El tratamiento en Fráncfort por parte de la entidad europea de un proveedor estadounidense no es en sí una transferencia, pero el CEPD afirma que el riesgo de «legislaciones nacionales contradictorias o de un acceso desproporcionado de las autoridades» debe sopesarse igualmente al elegir un encargado. Para la mayoría de los datos empresariales es un riesgo documentable; para los secretos profesionales, muchas organizaciones eligen un proveedor de propiedad europea o el autoalojamiento.
Opciones de residencia de datos en la UE de los principales proveedores
Todas las grandes plataformas ofrecen ya tratamiento en la UE, pero los valores por defecto difieren. La tabla refleja la documentación de cada proveedor tal como se comprobó en octubre de 2026.
| Plataforma | Cómo mantener el tratamiento en la UE o en Alemania | A qué prestar atención |
|---|---|---|
| Azure OpenAI en Microsoft Foundry | Un despliegue Standard (regional) trata los datos en la geografía de su recurso, por ejemplo Alemania. Un despliegue DataZone en un recurso de la UE mantiene el tratamiento dentro de los Estados miembros de la UE. | Los despliegues Global, incluido Global Batch, pueden tratar datos en cualquier lugar. Los prompts seleccionados para revisión humana de abusos permanecen en su geografía; desactivarlo requiere aprobación. |
| Amazon Bedrock | Llame a los modelos en Fráncfort (eu-central-1) cuando estén disponibles, o utilice un perfil de inferencia entre regiones de la UE, que mantiene el tratamiento en regiones de la UE. La AWS European Sovereign Cloud en Brandeburgo, operativa desde enero de 2026, ofrece Bedrock en una partición europea independiente. | Los perfiles globales enrutan a todo el mundo. Algunos modelos más recientes requieren un modo de retención que permite a AWS conservar los prompts para revisión humana hasta 30 días. |
| Google Vertex AI | Utilice un endpoint regional como europe-west3 (Fráncfort) o el endpoint multirregional de la UE, que abarca solo Estados miembros de la UE. | El endpoint global no ofrece garantía de residencia. Una caché en memoria con una vida de 24 horas está activada por defecto y puede desactivarse; el grounding con la Búsqueda de Google conserva registros hasta tres días. |
| API de OpenAI y ChatGPT Enterprise | Residencia de datos en Europa (EEE y Suiza) con tratamiento en la región para clientes de API que reúnan los requisitos, configurable por proyecto nuevo. Almacenamiento en reposo en Europa para espacios de trabajo ChatGPT Enterprise y Edu que reúnan los requisitos. | Requiere la aprobación de OpenAI y además retención cero de datos o una vigilancia de abusos modificada; los proyectos existentes no pueden cambiarse. Los registros de abusos de la API se conservan por defecto hasta 30 días. |
| API de Claude de Anthropic | No hay opción europea en la API propia: la geografía de inferencia es «global» o «us» y el almacenamiento de los espacios de trabajo es solo en EE. UU. Para el tratamiento en la UE, utilice Claude a través de perfiles de Bedrock en la UE o de endpoints de Vertex AI en la UE. | La disponibilidad regional en Bedrock y Vertex AI varía entre versiones de Claude, así que compruebe cada modelo antes de comprometerse. |
| Modelos de pesos abiertos en centros de datos alemanes | Ejecute modelos como Llama, Mistral, Qwen o gpt-oss en sus propias GPU o a través de una API gestionada alemana como STACKIT, IONOS o T-Systems. | Usted es responsable de la seguridad, los parches, la capacidad y la calidad. Compruebe la licencia del modelo y si un proveedor gestionado almacena las solicitudes. |
Dos distinciones importan más que la marca. El lugar de almacenamiento y el lugar de tratamiento son promesas distintas: varias opciones «globales» almacenan los datos en la UE pero ejecutan la inferencia en otro sitio. Y la región europea de un proveedor estadounidense resuelve la cuestión de las transferencias, no la de la CLOUD Act.
El autoalojamiento se ha vuelto realista. Con la generación aumentada por recuperación (RAG), un modelo de pesos abiertos de tamaño medio que responde a partir de sus propios documentos suele bastar para la búsqueda interna y la redacción. La guía de la DSK sobre RAG de octubre de 2025 señala que esto permite modelos más pequeños y ejecutados en local sin pasar datos personales a los hiperescaladores, pero que la RAG no subsana un modelo entrenado de forma ilícita.
Entrenamiento con sus datos, registros y conservación
Las condiciones empresariales y de API de los principales proveedores excluyen el entrenamiento con sus prompts sin permiso. Los planes de consumo son distintos. OpenAI y Anthropic permiten a los usuarios de consumo decidir si sus chats entrenan futuros modelos, y Anthropic conserva los chats de consumo hasta cinco años cuando el usuario permite el entrenamiento. Por eso la DSK quiere que el personal use cuentas de empresa, con el entrenamiento y el historial de chats desactivados por defecto.
- Vigilancia de abusos del proveedor. Hasta 30 días por defecto en OpenAI y en algunos modelos de Bedrock; Azure almacena en su geografía los prompts seleccionados para revisión humana salvo que se le apruebe una vigilancia de abusos modificada.
- Retención cero de datos. Disponible en los principales proveedores para clientes que reúnan los requisitos, pero normalmente no para funciones con estado como archivos, almacenes vectoriales o ejecución de código.
- Funciones con estado. Las respuestas almacenadas, los hilos y los archivos subidos permanecen hasta que los borre. Desactive el almacenamiento cuando no necesite historial.
- Sus propios registros. Fije un plazo (por ejemplo, 30 días para los registros completos de prompts), seudonimice los identificadores de usuario, restrinja el acceso y borre automáticamente. El artículo 5, apartado 1, letra e, lo exige, y un registro que no conserva no puede filtrarse.
Los registros de prompts que identifican a empleados pueden servir para supervisar su comportamiento o su rendimiento, lo que activa el derecho de codecisión del comité de empresa según el § 87, apartado 1, número 6, BetrVG, así que acuerde el diseño de los registros en un acuerdo de empresa antes del despliegue.
Qué espera la DSK alemana, y cuándo necesita una evaluación de impacto
Tres documentos de la DSK son relevantes para quienes usan IA: la guía de mayo de 2024 sobre IA y protección de datos, la guía de junio de 2025 sobre medidas técnicas y organizativas y la guía de octubre de 2025 sobre RAG. No son vinculantes, pero muestran cómo leen el RGPD las autoridades que le auditarían.
Technisch geschlossene Systeme sind daher aus datenschutzrechtlicher Sicht vorzugswürdig.
En español: desde el punto de vista de la protección de datos, son preferibles los sistemas técnicamente cerrados, en los que usted controla las entradas y las salidas y el proveedor no entrena con ellas. La misma guía le pide comprobar que el modelo se entrenó de forma lícita, excluir el entrenamiento con sus entradas cuando sea posible, fijar normas internas por escrito sobre qué herramientas pueden usarse para qué y dar al personal dispositivos y cuentas de empresa en lugar de privados.
Una evaluación de impacto relativa a la protección de datos según el artículo 35 es obligatoria cuando es probable que el tratamiento entrañe un alto riesgo, y la DSK espera que así sea en muchos despliegues de IA. Su lista obligatoria para el sector privado incluye, como punto 11, el uso de IA para tratar datos personales con el fin de dirigir la interacción con los interesados o evaluar aspectos personales, con la atención al cliente mediante IA como ejemplo. Desencadenantes típicos:
- Un chatbot o un agente de voz de cara al cliente que trata datos personales.
- Una IA que puntúa, clasifica o elabora perfiles de personas: candidatos, empleados, riesgo crediticio o de fraude.
- Categorías especiales de datos según el artículo 9, como los datos de salud, o datos de menores.
- La supervisión sistemática de empleados, incluido el análisis de sus prompts.
Si persiste un riesgo residual alto, el artículo 36 le obliga a consultar a la autoridad de control antes de la puesta en marcha. Pida pronto a los proveedores la documentación que necesita para evaluar el riesgo.
Qué configuración encaja con qué datos
| Datos | Ejemplos | Configuración que suele encajar | Controles mínimos |
|---|---|---|---|
| Sin datos personales | Contenido web público, borradores de marketing, código sin secretos | Cualquier plan empresarial o API con el entrenamiento desactivado; el enrutamiento global es aceptable | Política de uso, cuentas de empresa |
| Datos personales ordinarios | Correos de clientes, notas del CRM, tickets de soporte, actas de reuniones | Despliegue con tratamiento en la UE: Azure regional o EU DataZone, Bedrock en Fráncfort o un perfil de la UE, endpoint de Vertex AI en la UE, residencia en Europa de OpenAI | Contrato de encargo, tratamiento en la UE, entrenamiento desactivado, conservación de 30 días o menos, base de transferencia para cualquier acceso desde EE. UU. |
| Sensibles o de alto riesgo | Datos de salud, evaluaciones de RR. HH., filtrado de candidatos, datos de menores | Despliegue regional en Alemania con retención cero o vigilancia de abusos modificada, o un modelo de pesos abiertos autoalojado | Evaluación de impacto, acceso estricto, revisión humana de las decisiones (artículo 22), conservación breve de registros |
| Secretos profesionales y joyas de la corona | Historias clínicas, expedientes de clientes de abogados y asesores fiscales, cifras financieras no publicadas, I+D | Modelo de pesos abiertos en su propia infraestructura o en un proveedor alemán de propiedad europea | Compromisos de confidencialidad según el § 203 StGB cuando se aplique, revisión jurídica, ningún acceso desde terceros países |
Un ejemplo práctico
Una empresa logística hipotética de 400 personas en Renania del Norte-Westfalia quiere un agente que lea unos 1.500 correos de clientes a la semana, redacte respuestas y actualice el CRM. Los correos contienen nombres, direcciones y reclamaciones por mercancía dañada: datos personales ordinarios, pero de cara al cliente y a escala, así que procede una evaluación de impacto.
Una configuración razonable: la orquestación en el propio tenant de Azure de la empresa en Alemania, un despliegue del modelo en EU DataZone, las respuestas almacenadas desactivadas, los registros de prompts conservados 30 días con identificadores seudonimizados, el acceso al CRM limitado a notas en borrador y una persona que aprueba cada respuesta. El contrato de encargo de Microsoft cubre el tratamiento, el marco y las cláusulas tipo cubren el acceso residual desde EE. UU., y el comité de empresa acuerda el diseño de los registros.
Lista de control: antes de activarlo
Despliegue de IA conforme al RGPD
- Haga un inventario de todas las herramientas de IA en uso, incluidas las cuentas privadas, y decida cuáles se permiten y para qué.
- Dibuje el flujo de datos de cada caso de uso: interfaz, orquestación, endpoint del modelo, herramientas, almacenes y registros.
- Firme el contrato de encargo del proveedor, archive la lista de subencargados y añada el tratamiento a su registro del artículo 30.
- Elija un despliegue que trate los datos en la UE o en Alemania y bloquee por política el enrutamiento global cuando pueda.
- Confirme por escrito que las entradas y las salidas no se utilizan para entrenar, y desactive el entrenamiento en todas las cuentas.
- Documente la base de transferencia para cualquier acceso desde EE. UU.: certificación DPF, cláusulas contractuales tipo y una evaluación de impacto de la transferencia.
- Fije la conservación de los registros de abusos del proveedor, las respuestas almacenadas, los archivos, los almacenes vectoriales, las cachés y sus propios registros.
- Haga un cribado de evaluación de impacto y una evaluación completa para los casos de uso de cara al cliente, de RR. HH. o sensibles.
- Actualice la información de privacidad (artículos 13 y 14), acuerde el uso de la IA y los registros con el comité de empresa, y forme al personal sobre qué puede introducirse en un prompt.
- Revise la configuración cada seis meses: las condiciones de los proveedores, las regiones de los modelos y la situación jurídica del marco cambian a menudo.
Cómo podemos ayudarle
Bespoke IT Consultants construye agentes de IA y automatizaciones para empresas de la región DACH, con alojamiento en la UE o en Alemania elegido para cada caso de uso. Una auditoría de IA analiza sus herramientas, sus flujos de datos y sus carencias, o bien póngase en contacto para hablar de un caso de uso concreto. Para la validación jurídica, cuente con su delegado de protección de datos y, en los casos de alto riesgo, con un abogado.
¿Tiene una pregunta sobre su propio caso?
Pregunte a nuestro asistente de IA. Responde en segundos y una persona de nuestro equipo hace el seguimiento.

Bespoke One Coworker. Asistente de IA. Respuestas en segundos, presupuesto en tres minutos.